
项目介绍
MonkeyOCR 面向文档解析,可把扫描页面中的文字、表格与公式组织成可编辑内容。适合制作知识库输入材料,识别质量要用自己的真实文档评估,不直接套用公开榜单成绩。
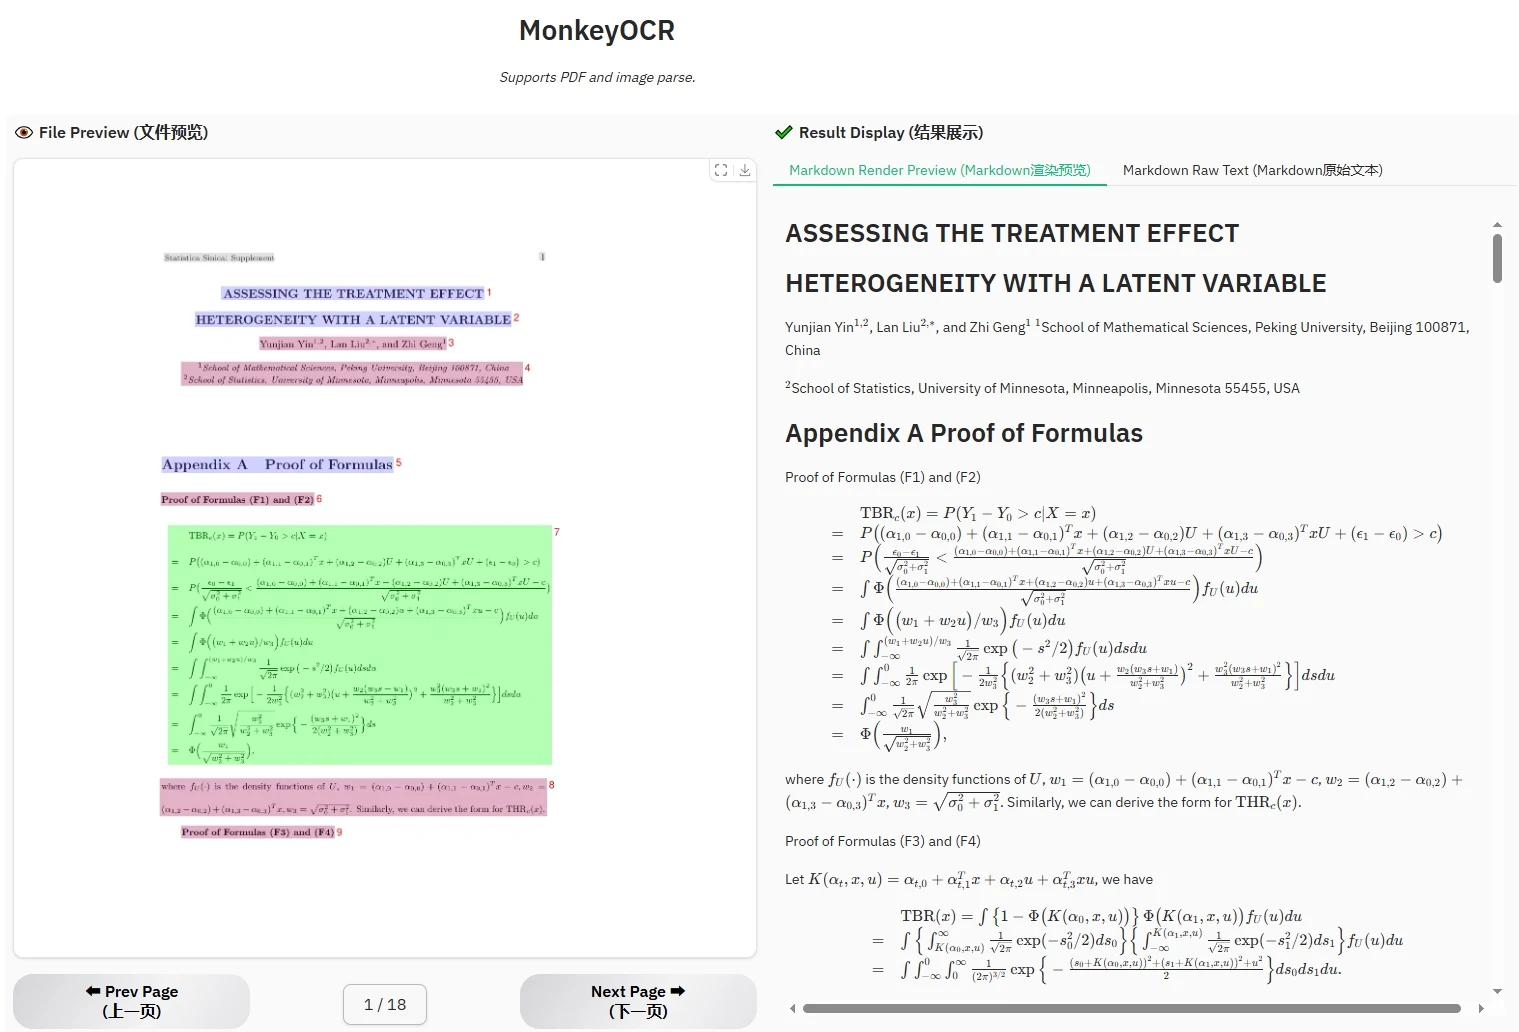
文档页面经过布局与内容解析,输出 Markdown 等结构化结果。段落顺序、表格和公式比字符总量更能体现可用性。
适合扫描资料和知识库前处理。先核对推理硬件与权重,再用自己的样本评估。
核心功能
| 功能 | 作用与使用方式 |
|---|---|
| 文档解析 | 提取文字和结构 |
| 表格处理 | 核对行列对应 |
| 公式识别 | 检查符号与上下标 |
| 中间结果 | 保留布局与 JSON |
| 批量任务 | 记录页码与失败项 |
界面展示
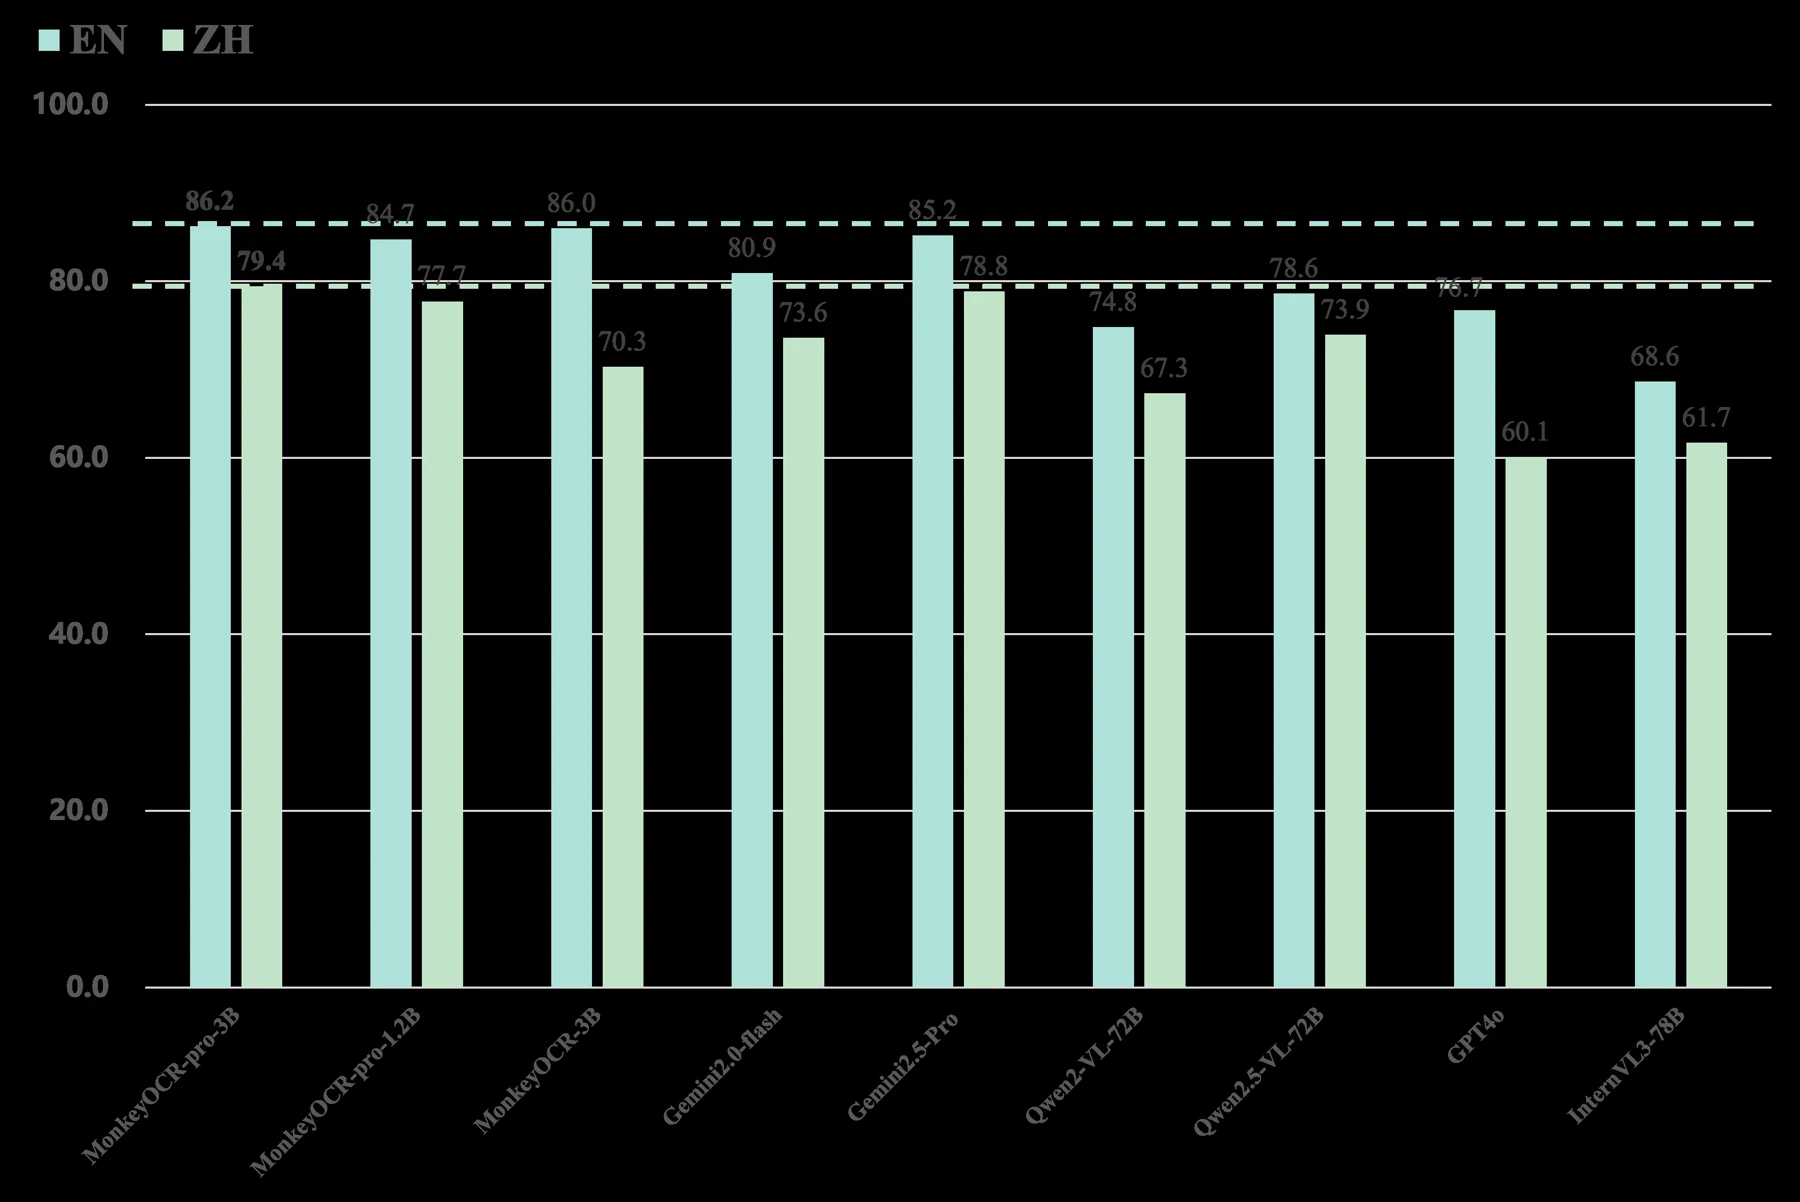
图 1:官方仓库提供的项目示意图,用于说明功能与布局。
项目信息
| 项目 | 说明 |
|---|---|
| 类型 | 项目指南 |
| 分类 | AI 与开发 |
| 项目仓库 | Yuliang-Liu/MonkeyOCR |
| 整理日期 | 2026-11-14 |
安装与运行
在配备受支持 NVIDIA GPU 的 Linux 电脑准备驱动、NVIDIA Container Toolkit、Docker 和 Compose。以下为 GPU 源码构建,普通无 NVIDIA GPU 的群晖不能照此直接运行。
1. 安装和初始化
mkdir -p "$PWD/monkeyocr-work"
cd "$PWD/monkeyocr-work"
git clone https://github.com/Yuliang-Liu/MonkeyOCR.git source
nvidia-smi
2. 第一次使用
将下面完整配置保存为当前目录 compose.yaml,再执行构建与启动。模型保存在独立 models 目录,首次启动按日志等待模型准备。先用一页无敏感内容的扫描件验证文字、段落顺序和表格,再处理多页 PDF。
完整 GPU Compose
services:
  monkeyocr:
    image: monkeyocr-local:latest
    build:
      context: ./source
      dockerfile: docker/Dockerfile
      args:
        BUILDKIT_INLINE_CACHE: "1"
        LMDEPLOY_PATCHED: "false"
    restart: unless-stopped
    ports:
      - "7860:7860"
    volumes:
      - ./models:/app/MonkeyOCR/model_weight
    environment:
      TMPDIR: /app/tmp
      CUDA_VISIBLE_DEVICES: "0"
      HF_HUB_CACHE: /app/MonkeyOCR/model_weight
      MODELSCOPE_CACHE: /app/MonkeyOCR/model_weight
    deploy:
      resources:
        reservations:
          devices:
            - driver: nvidia
              count: 1
              capabilities: [gpu]
docker compose config --quiet
docker compose build --pull
docker compose up -d
docker compose logs --tail=100
浏览器访问 GPU 主机的 7860 端口。驱动不可见与模型下载失败分别排查,不通过删除 GPU 声明强行把 CUDA 版本当成 CPU 版。更新先保存源码提交、模型目录和输出文档,再重新构建。
常见问题
- 命令不存在:确认依赖已安装,关闭并重新打开终端,再检查实际使用的环境。Python 虚拟环境与系统 Python、Windows 与 WSL 的工具路径各自独立。
- 下载依赖失败:先查看具体失败的仓库和包名,检查该终端的网络;浏览器能访问不代表命令行已使用同一代理。
- 配置后仍报错:从当前项目目录启动,检查配置文件名、变量名和日志。真实账号与 API Key 放在本机私有配置中,不复制到公开教程或截图。
更新与备份
更新前保存项目配置、输入资料和输出结果。源码项目记录当前提交与依赖锁文件,比较新版本说明后再更新;安装包项目保留可回退的版本号。服务账号的授权与模型账单在对应平台管理,删除本地目录不会自动撤销授权。