
项目介绍
PaddleOCR 提供文字识别及文档解析能力,可用于扫描件转文字、表格提取和后续知识库处理。不同任务使用的模型、推理依赖和硬件要求不同,先选清楚任务再安装。
文字检测、识别和版面解析服务不同目标。仅识字与重建表格、公式或阅读顺序所需模型并不相同。
适合扫描资料数字化和知识库前处理。先选择任务类型与硬件路线,记录版本后再批量运行。
核心功能
| 功能 | 作用与使用方式 |
|---|---|
| 文字识别 | 提取截图与扫描文字 |
| 版面处理 | 观察多栏阅读顺序 |
| 表格解析 | 核对行列对应 |
| 批量任务 | 保留页码与文件名 |
| 结果导出 | 连接后续检索流程 |
界面展示
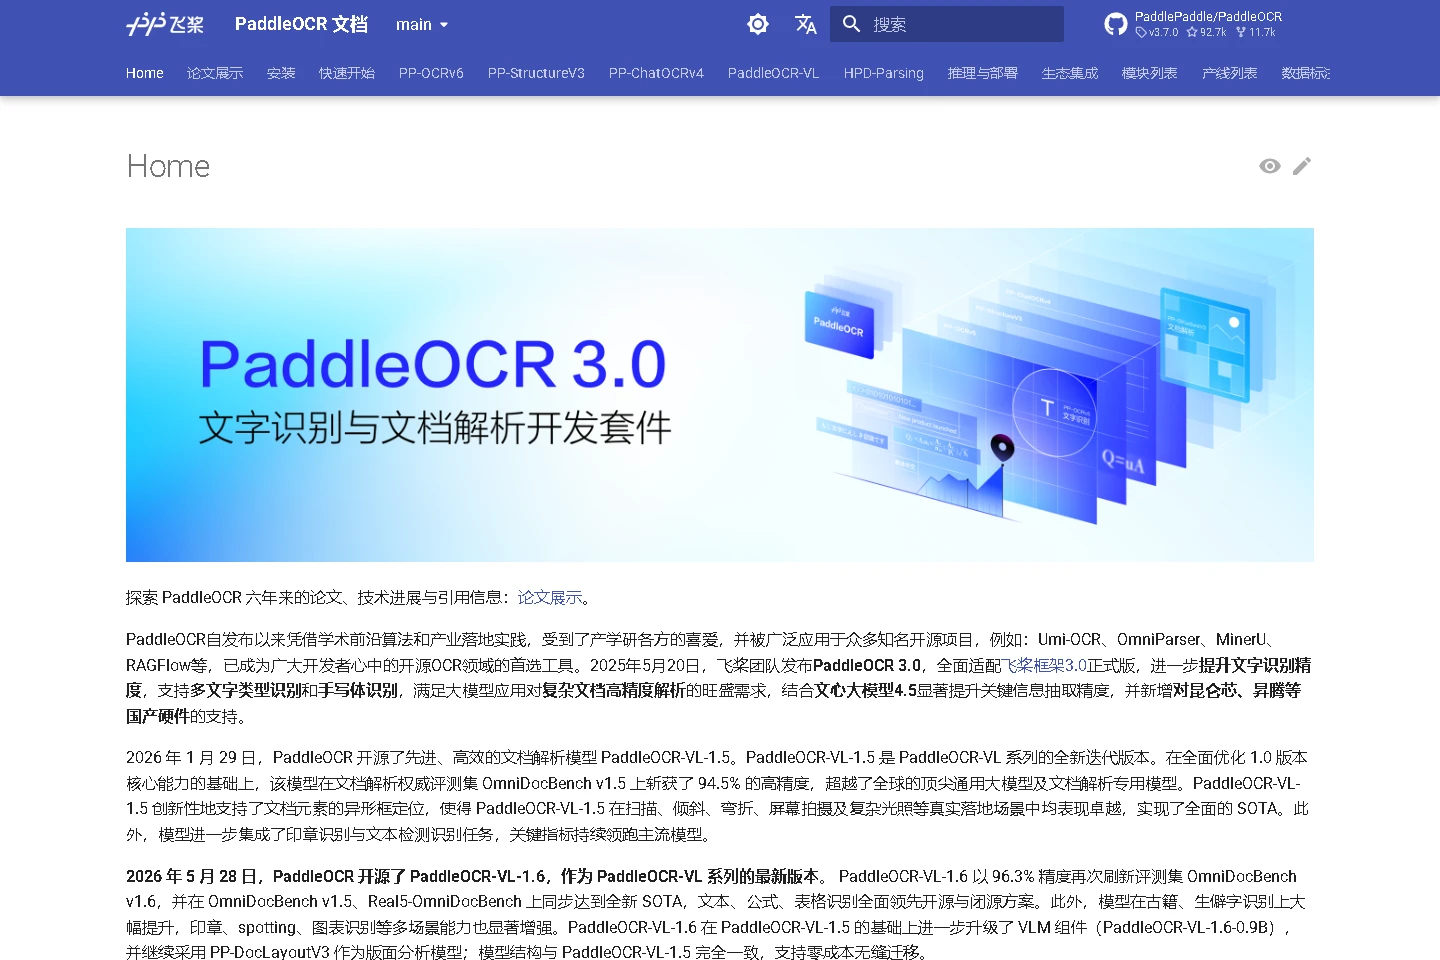
图 1:官方公开页面截图,用于说明项目入口与功能;不是本机部署画面。
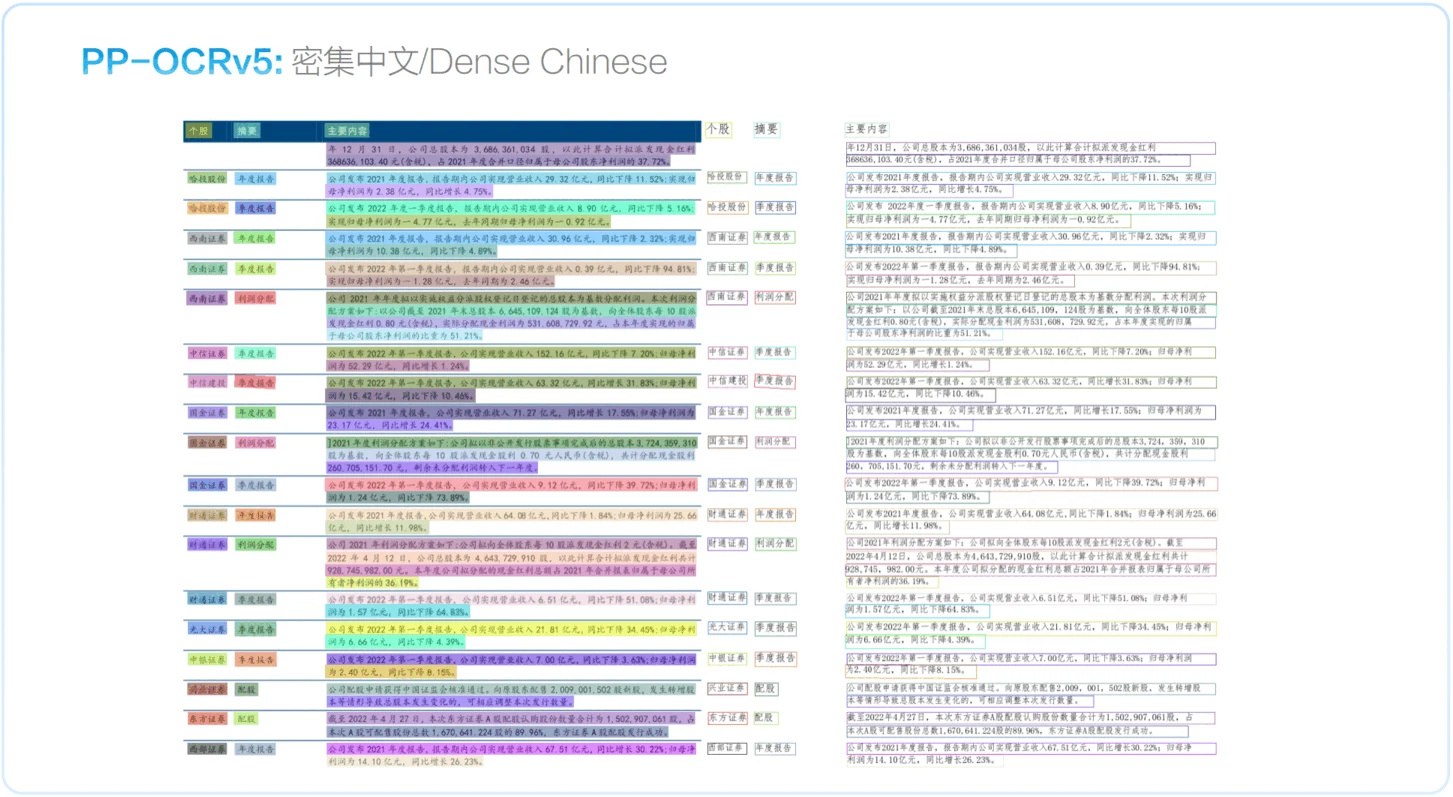
项目信息
| 项目 | 说明 |
|---|---|
| 类型 | 项目指南 |
| 分类 | AI 与开发 |
| 项目仓库 | PaddlePaddle/PaddleOCR |
| 官方入口或文档 | 直接访问 |
| 整理日期 | 2026-11-14 |
安装与运行
在官方支持的 Linux/Windows Python 环境建立虚拟环境。下方使用 CPU 推理,先确认当前 Python 与 PaddlePaddle 3.2.0 的 wheel 支持;群晖 ARM 环境不能假定直接兼容。
1. 安装和初始化
python3 -m venv .venv
source .venv/bin/activate
python -m pip install paddlepaddle==3.2.0 -i https://www.paddlepaddle.org.cn/packages/stable/cpu/
python -m pip install "paddleocr[all]"
paddleocr --help
2. 第一次使用
把一张自己准备的图片保存为 input.png,在当前目录运行:
paddleocr ocr -i ./input.png --use_doc_orientation_classify False --use_doc_unwarping False --use_textline_orientation False --engine paddle
首次推理会下载模型,完成后核对识别顺序、漏字与置信度。先做普通 OCR,再逐项开启文档矫正和版面分析,不在低内存环境一次加载全部模型。
常见问题
- 命令不存在:确认依赖已安装,关闭并重新打开终端,再检查实际使用的环境。Python 虚拟环境与系统 Python、Windows 与 WSL 的工具路径各自独立。
- 下载依赖失败:先查看具体失败的仓库和包名,检查该终端的网络;浏览器能访问不代表命令行已使用同一代理。
- 配置后仍报错:从当前项目目录启动,检查配置文件名、变量名和日志。真实账号与 API Key 放在本机私有配置中,不复制到公开教程或截图。
更新与备份
更新前保存项目配置、输入资料和输出结果。源码项目记录当前提交与依赖锁文件,比较新版本说明后再更新;安装包项目保留可回退的版本号。服务账号的授权与模型账单在对应平台管理,删除本地目录不会自动撤销授权。