
n8n:把网盘新文件登记到飞书表格
这个工作流按计划检查指定网盘目录,把新文件的名称、时间与需要的分享信息登记到飞书多维表格。适合资料登记,重点是去重、权限和链接失效处理。 网盘文件 ID 用作稳定键,流程比较已有记录后新增或更新飞书行。分享链接的有效期和删除状态需要持续维护。 适合资料登记自动化。无需公开的文件只登记元信息,不必全部创建分享链接。
AI 工具、智能体、编程与自动化
 AI 与开发
这个工作流按计划检查指定网盘目录,把新文件的名称、时间与需要的分享信息登记到飞书多维表格。适合资料登记,重点是去重、权限和链接失效处理。 网盘文件 ID 用作稳定键,流程比较已有记录后新增或更新飞书行。分享链接的有效期和删除状态需要持续维护。 适合资料登记自动化。无需公开的文件只登记元信息,不必全部创建分享链接。
 AI 与开发
n8n 可以把资料收集、模型整理、格式转换和草稿保存连接成工作流。适合减少重复操作,内容事实、图片来源与最终发布仍应由编辑审核。 这套流程的目标是减少「复制资料、整理结构、填写草稿」的重复劳动。需要先把每一步的数据约定清楚,再连接模型与内容平台;否则流程即使全部显示执行成功,也可能只保存了一篇空正文或重复文章。
 AI 与开发
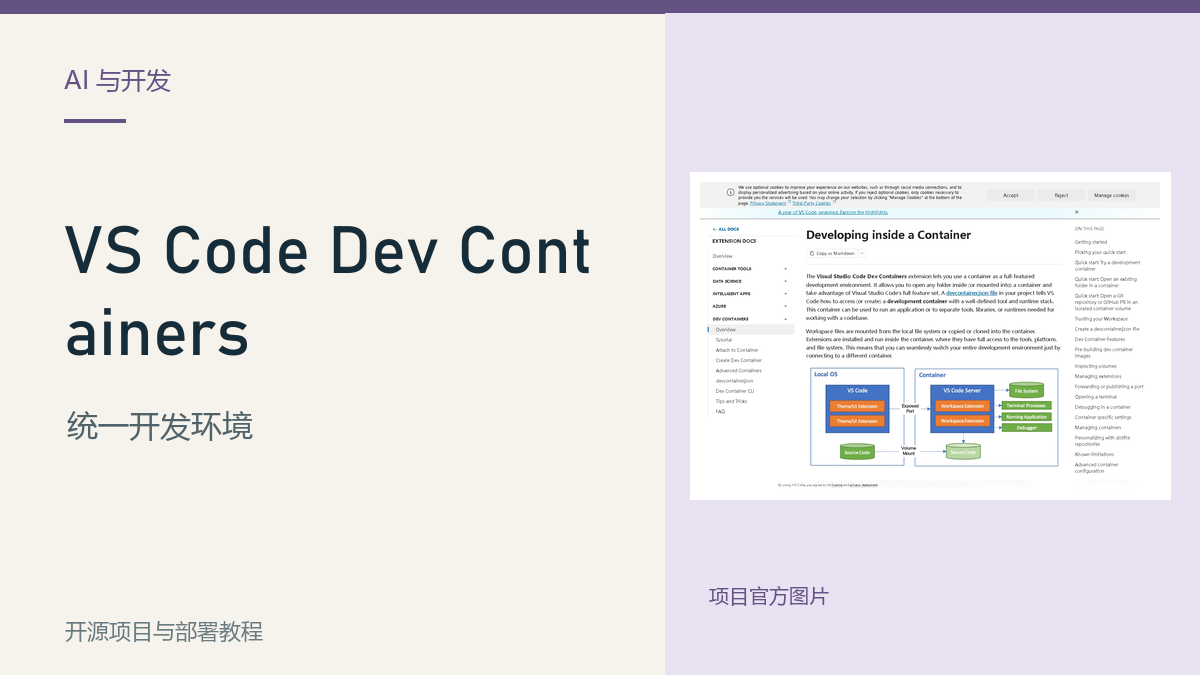
Dev Containers 把项目工具链放进容器,让 VS Code 使用容器里的运行时、终端与依赖。适合不同电脑保持相近开发环境,也适合通过 Remote SSH 使用自己的远程主机。 编辑器连接容器中的工具链,终端、运行时和依赖在统一环境工作。项目源文件与容器环境配置可以共同管理。 适合多电脑开发或远程主机开发。先使用官方语言模板,再加入项目必需依赖。
 AI 与开发
PaddleOCR 提供文字识别及文档解析能力,可用于扫描件转文字、表格提取和后续知识库处理。不同任务使用的模型、推理依赖和硬件要求不同,先选清楚任务再安装。 文字检测、识别和版面解析服务不同目标。仅识字与重建表格、公式或阅读顺序所需模型并不相同。 适合扫描资料数字化和知识库前处理。先选择任务类型与硬件路线,记录版本后再批量运行。
 AI 与开发
NotebookLM 是围绕指定资料开展阅读、摘要和问答的在线工具。它适合比较几份文档、整理学习材料和追踪回答引用,比直接询问通用聊天模型更便于回到来源核实。 笔记本围绕一组来源组织问答与总结,引用让用户回到原文检查。来源版本变化时,应同步检查已有笔记。 适合学习资料、报告和项目文档阅读。按主题建库,小范围问题更容易获得可核实结果。
 AI 与开发
auto_captcha 是浏览器扩展,调用配置好的模型识别页面图片中的验证码并辅助填入。适合在自己维护或获准测试的页面中减少重复输入,实际识别率受图片样式与模型能力影响。 扩展选取验证码图片,调用模型识别并填入对应字段。检测规则与识别模型分别影响结果,页面变化后需要重新核对。 适合自己的测试页面与获准操作范围。先检查单次识别,不配置反复自动提交。
 AI 与开发
Spaces 是 Hugging Face 的应用托管空间,常用于 Gradio、Streamlit 或 Docker 演示。它把代码仓库、构建和运行界面放在一起,适合模型体验页和小型工具展示。CPU 内存、磁盘、休眠与付费硬件属于不同资源限制,不能当作永久在线的通用服务器。 代码提交触发构建,应用运行后通过 Space 页面展示。SDK、硬件、休眠和存储设置共同决定运行方式。 适合模型演示和小型网页工具。先提交最小应用,确认依赖与监听地址,再添加耗资源的模型。
 AI 与开发
LangBot 将消息平台、模型和插件组织在统一运行环境中。建议一次接通一个平台,先确认基础消息,再增加知识库或工具。 消息适配器接收平台事件,模型生成响应,插件与知识库按需扩展。每个渠道的鉴权、触发规则和会话划分都应独立设置。 适合将模型接入日常聊天平台。先限定测试用户和单个平台,确认稳定后再扩大范围。
 AI 与开发
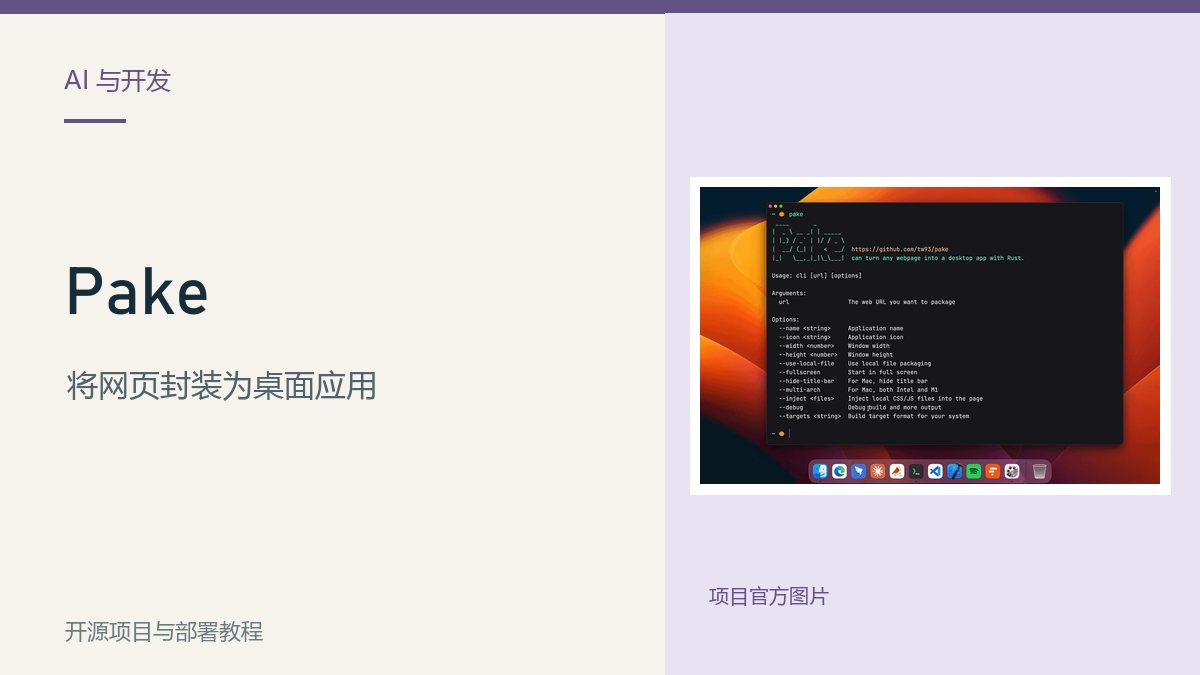
Pake 基于 Tauri 把网页封装成独立桌面窗口,适合为常用网站建立单独的图标、窗口和启动入口。它使用系统相关的 WebView 能力,打包结果仍然依赖原网站提供内容与服务。
 AI 与开发
Gemini Computer Use Preview 是 Google 提供的浏览器操作示例。程序把页面截图交给模型分析,再把模型返回的点击、输入、滚动等动作交给浏览器执行,完成后继续截图,直到任务结束。